

O arquivo robots.txt é o porteiro absoluto do seu site: um único erro de configuração aqui pode fazer seu negócio desaparecer dos resultados do Google e IAs instantaneamente, tornando irrelevante qualquer esforço de design ou conteúdo. Mais do que um simples arquivo de texto, ele é a peça central do SEO Técnico moderna, responsável por gerenciar seu Crawl Budget (orçamento de rastreamento) e, agora, definir a soberania de dados contra o uso não autorizado por IAs generativas (como ChatGPT e Gemini). Neste guia de desenvolvimento de sites, vamos além do básico: você aprenderá a configurar o robots.txt no WordPress para blindar sua infraestrutura, otimizar a indexação e garantir que apenas os robôs que trazem lucro tenham acesso ao seu servidor.
O que é o Arquivo robots.txt na Engenharia de Busca?
Na arquitetura da internet, o robots.txt é o primeiro ponto de contato entre o seu servidor e qualquer visitante não humano. Antes de o Googlebot (o robô do Google) baixar uma única imagem ou ler uma linha de texto do seu site, ele verifica se esse arquivo existe. Se a resposta for positiva, ele lê as instruções; se não, ele assume que o acesso é livre e irrestrito.
Tecnicamente, ele é um arquivo de texto simples (ASCII ou UTF-8) hospedado na raiz do seu domínio (seusite.com.br/robots.txt) que utiliza o Protocolo de Exclusão de Robôs. No entanto, vê-lo apenas como um arquivo de texto é perigoso. Na prática, ele funciona como as “Regras da Casa” para convidados automáticos.
A Metáfora do "Porteiro": Quem entra e quem fica de fora
Imagine o seu site como um edifício corporativo de alta segurança e o robots.txt como o chefe da portaria.
- O Visitante (User-agent): É o robô. Pode ser o Googlebot (um inspetor oficial), o GPTBot (um estudante curioso que quer copiar seus livros) ou um bot malicioso.
- A Regra (Disallow/Allow): É a ordem do porteiro. “Você pode entrar no saguão (Home), mas não pode entrar no arquivo morto (wp-admin, política de Privacidade)”.
Sem um porteiro eficiente (robots.txt), robôs de rastreamento (user-agent) podem sobrecarregar seus elevadores e corredores (consumindo recursos do servidor), entrando em salas que deveriam ser privadas ou irrelevantes para o público.
A Diferença Crítica entre Disallow (robots.txt) e noindex (Meta Tag)
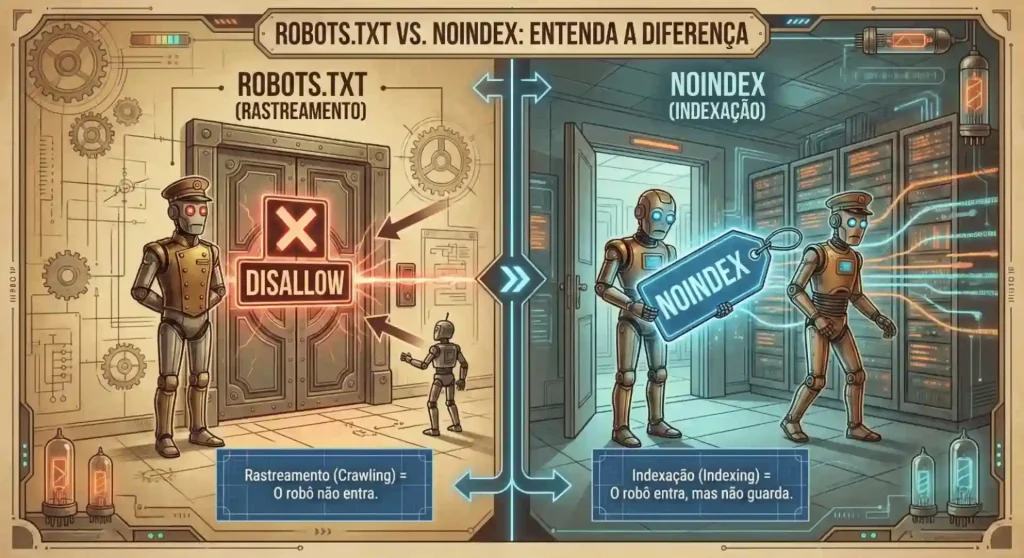
Este é o ponto onde a engenharia semântica se separa do “achismo”. Existe uma confusão comum de que bloquear uma página no robots.txt impede que ela apareça no Google. Isso não é verdade.
Para dominar o SEO Técnico, você precisa distinguir duas ações:
- Rastreamento (Crawling): O ato do robô visitar e ler a página. O robots.txt controla isso.
- Indexação (Indexing): O ato do Google guardar a página no seu banco de dados e mostrá-la nos resultados. A meta tag noindex controla isso.
O Perigo do Bloqueio Errado:
Se você usar Disallow: /pagina-secreta/ no robots.txt, o Googlebot obedecerá e não entrará na página. Porém, se outro site linkar para essa página, o Google saberá que a URL existe e poderá exibi-la nos resultados de busca sem a descrição (snippet), apenas com o link azul.
Nota do Especialista: Para remover uma página do Google com certeza, você deve permitir o rastreamento no robots.txt e adicionar a tag noindex no cabeçalho da página. O robô precisa entrar para ler e receber a ordem de “não indexar”.
Nos nossos projetos de desenvolvimento de sites profissionais, configuramos essa arquitetura de permissões meticulosamente para garantir que páginas de teste, políticas de privacidade ou áreas administrativas nunca diluam a autoridade do seu domínio principal.
A Nova Fronteira: Gerenciando Bots de IA (ChatGPT, Gemini e Claude)
Até recentemente (2025), o arquivo robots.txt tinha apenas uma função: guiar o Google Search. Hoje, o cenário mudou drasticamente. A internet não é mais visitada apenas por buscadores, mas por “Mecanismos de Resposta” e IAs Generativas que varrem a web para treinar seus modelos (LLMs).
Isso cria um novo desafio para donos de sites: Soberania de Dados. Você precisa decidir se o seu conteúdo deve alimentar a inteligência do ChatGPT e do Google Gemini ou se deve ser protegido.
O Dilema Estratégico: Visibilidade vs. Propriedade Intelectual
Antes de colar qualquer código, você precisa definir o objetivo do negócio. Na Engenharia Semântica, dividimos isso em duas estratégias opostas:
1. Estratégia de Proteção (“Walled Garden”)
Para quem é: Jornais, blogs de notícias, produtores de cursos ou relatórios exclusivos.
O objetivo: Impedir que a IA leia seu conteúdo e entregue a resposta pronta para o usuário, “roubando” o clique que viria para o seu site. Se você vende informação, bloquear a IA é vital para não perder tráfego.
2. Estratégia de Visibilidade (GEO – Generative Engine Optimization)
Para quem é: Prestadores de serviços (Advogados, Médicos, Profissionais liberais), Comércio Local e Marcas Institucionais.
O objetivo: Você quer que a IA saiba tudo sobre você. Se um usuário perguntar ao ChatGPT “Indique um Advogado Tributarista em Londrina”, o robô só poderá recomendar sua marca se tiver lido e “entendido” seu site. Nesse caso, bloquear é um erro.
Na criação de sites profissionais, tendemos a recomendar o caminho da abertura para maioria dos nichos como consultorias, negócios locais, profissionais liberais. E o caminho da proteção apenas onde faz sentido preservar o valor único da marca.
Quem é quem? Os Robôs que você precisa conhecer
Este é o ponto onde muitos “profissionais” na hora do desenvolvimento web cometem erros graves por falta de conhecimento. Para não cometer erros fatais (como sumir do Google), entenda a diferença:
- Googlebot (O Intocável): É o robô da Pesquisa Google. Ele coloca seu site nos resultados de busca (links azuis). Jamais bloqueie este bot.
- Google-Extended (O Treinador): É o robô que coleta dados para treinar o Gemini e o Vertex AI. Bloqueá-lo impede que o Google use seus textos para criar respostas de IA, mas mantém seu site na pesquisa normal.
- GPTBot: O robô da OpenAI (ChatGPT).
- CCBot (Common Crawl): Um robô agressivo que coleta dados para treinar IAs da Apple, Meta e outras. Consome muito servidor e traz zero clik.
A boa notícia: Você pode bloquear o Google-Extended para impedir que o Google use seus textos para treinar a IA dele, sem perder nenhuma posição no ranking de pesquisa tradicional. É o melhor dos dois mundos: visibilidade na busca, proteção contra a cópia generativa.
Mão na Massa: Configurando robots.txt via Rank Math Pro
Esqueça FTP ou acesso ao servidor. Como utilizamos a suíte Rank Math Pro em nossos projetos de desenvolvimento, a edição é feita de forma segura e visual dentro do painel do WordPress.
- Acesse o Painel WordPress.
- Vá em Rank Math Pro> Configurações Gerais.
- Clique na aba Editar robots.txt.
- O Rank Math criará um arquivo virtual. Você pode editar diretamente na caixa de texto.
Qual código usar no robots.txt? Escolha sua Estratégia
- Opção A: Quero ser citado pelas IAs (Foco em GEO e Marca)
Se você quer ser recomendado pelo ChatGPT e Gemini, o segredo é a permissividade controlada.
Nota: Não é necessário colocar “Allow”. Basta não colocar “Disallow”. O padrão da web é o acesso livre. Mantenha seu arquivo limpo.
Copie este código no Rank Math:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# Sitemap (Essencial para a IA encontrar suas páginas)
Sitemap: https://seusite.com.br/sitemap_index.xml

# Bloqueio apenas de bots inúteis (economiza servidor)
User-agent: CCBot
Disallow: /
Por que bloquear o CCBot aqui? Porque ele consome muito recurso de servidor e raramente gera citação direta de marca como o GPTBot ou Google.
- Opção B: Proteção Total (Não usem meu conteúdo para treinar IA)
Se você quer blindar sua propriedade intelectual.
Copie este código no Rank Math Pro:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# Sitemap
Sitemap: https://seusite.com.br/sitemap_index.xml

# Bloqueio de Treinamento de IA (Proteção de Dados)
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Ao implementar essas diretivas, você assume o controle da sua propriedade intelectual digital. Na ARD Marketing nossos projetos de desenvolvimento web, essa configuração é revisada a cada atualização de algoritmo para garantir que sua estratégia de dados esteja sempre à frente do mercado.
Crawl Budget: Otimizando a "Verba de Rastreamento"
Muitos donos de sites acreditam que o Google tem recursos infinitos e que rastreará todas as páginas do seu site instantaneamente. Isso é um mito. O Google define uma “verba” (Crawl Budget) para cada domínio, baseada na autoridade do site e, principalmente, na velocidade do servidor.
Se o Googlebot chega ao seu site e encontra lentidão ou milhares de URLs inúteis (como filtros de produtos, tags duplicadas ou arquivos de cache), ele “gasta” essa verba sem chegar ao conteúdo que realmente importa. O resultado? Seus artigos novos demoram dias para indexar e suas atualizações de produtos não aparecem na busca.
Como sites grandes desperdiçam a atenção do Google
Imagine que o Googlebot é um cliente com pressa em um supermercado. Se ele tiver que passar por corredores vazios ou trancados antes de achar o produto, ele vai embora.
No desenvolvimento de sites WordPress, os maiores vilões do Crawl Budget que devem ser bloqueados no robots.txt são:
- Filtros de E-commerce: /filtro?cor=azul&tamanho=m (Isso gera URLs infinitas).
- Resultados de Busca Interna: /search?q=termo (O Google não quer indexar sua busca interna).
- Feeds RSS: /feed/ (A menos que você seja um portal de notícias, isso é irrelevante para SEO).
- Arquivos de Login: /wp-login.php (Segurança básica).
Ao bloquear esses caminhos com Disallow, você diz ao Google: “Não perca tempo aqui. Vá direto para os meus artigos e páginas de vendas.”
A relação direta entre robots.txt e Performance (WPO)
Aqui está um segredo de bastidores: O Crawl Budget é elástico. Se o seu site responde rápido, o Google aumenta a verba e rastreia mais páginas. Se o site é lento, ele reduz a visita.
É por isso que, na ARD Marketing, nunca tratamos o robots.txt isoladamente. Ele faz parte de um ecossistema. Um arquivo robots.txt perfeitamente configurado não salvará um site hospedado em um servidor lento.
Dica do Especialista: Para maximizar sua indexação, combinamos as regras de bloqueio com uma infraestrutura de e plugins de cache como WP Rocket. Quando o servidor entrega a página em milissegundos, o Googlebot consegue ler o dobro de conteúdo no mesmo tempo.
Quando se preocupar com o Crawl Budget?
- Sites Pequenos (até 500 URLs): O Crawl Budget raramente é um problema, a menos que o servidor seja péssimo.
- Sites Médios e Grandes (Portais e SEO Local): A otimização via robots.txt é obrigatória. Sem ela, você terá o problema de “Descoberta, mas não indexada” no Google Search Console.
Antigamente, editar o robots.txt exigia abrir um programa de FTP (File Transfer Protocol), baixar um arquivo do servidor, editar no Bloco de Notas e subir novamente. Um erro de digitação ali poderia derrubar o acesso do Google ao site inteiro.
No desenvolvimento de sites modernos, essa prática é obsoleta e perigosa.
O WordPress cria o que chamamos de robots.txt virtual. O arquivo não existe fisicamente na pasta do servidor; ele é gerado dinamicamente pelo CMS toda vez que alguém tenta acessá-lo. Isso permite que plugins de SEO, como o Rank Math Pro, gerenciem as regras com segurança, criando backups e evitando conflitos.
Editando robots.txt via Rank Math Pro: Segurança e Validação
Na ARD Marketing, padronizamos a edição via painel do WordPress. Isso garante que, mesmo que você não seja um programador, consiga proteger seu site sem riscos.
O caminho é simples, mas poderoso:
- No menu lateral do WordPress, vá em Rank Math SEO > Configurações Gerais.
- Clique na aba Editar robots.txt.
- Se houver um arquivo físico no servidor (criado antigamente), o Rank Math avisará que ele não pode editar. Nesse caso, você deve excluir o arquivo físico via hospedagem para assumir o controle total pelo painel.
Essa centralização é vital. Imagine precisar bloquear um bot malicioso em 50 sites de clientes. Pelo painel, a gestão é imediata.
Decifrando a Sintaxe do robots.txt: O que significam os comandos?
Antes de copiar e colar os códigos que fornecemos na seção anterior, você precisa saber ler a “língua dos robôs”. O robots.txt segue uma lógica simples de Quem e Onde.
1. User-agent: (Quem)
Define para qual robô a regra se aplica.
- User-agent: * = Aplica-se a todos os robôs do mundo.
- User-agent: Googlebot = Aplica-se apenas ao robô do Google.
2. Disallow: (Onde NÃO ir)
O comando de bloqueio.
- Disallow: /wp-admin/ = Não entre na pasta de administração.
- Disallow: / = Não entre no site inteiro (Cuidado extremo aqui!).
Usado para abrir uma exceção dentro de um bloqueio.
- Exemplo: Você bloqueou a pasta /wp-admin/, mas precisa que o robô leia o script /wp-admin/admin-ajax.php para o site funcionar.
A localização do seu mapa do site. É fundamental declarar isso no final do arquivo para facilitar a vida dos bots.
Nota Técnica: A ordem importa. Os robôs leem de cima para baixo. Regras específicas (para Googlebot) devem vir antes ou depois das regras gerais (*), dependendo da interpretação do bot, mas o padrão moderno é agrupar blocos por User-agent para clareza.
As "Regras de Ouro" do robots.txt e Erros Fatais
O robots.txt é poderoso, mas implacável. Ele não pergunta “você tem certeza?”. Se você digitar um comando errado, o Google obedece imediatamente e remove seu site do índice.
Na gestão de projetos de desenvolvimento de sites, seguimos um checklist rigoroso para garantir que a segurança não mate a visibilidade. Aqui estão os três pilares que você deve memorizar.
O Erro Fatal: Disallow: / (O Botão de Pânico)
Este é o comando mais perigoso da internet.
A barra (/) significa “raiz do site”. Ao dizer “Não entre na raiz”, você está efetivamente dizendo “Não entre em lugar nenhum”.
Onde o erro acontece:
Muitas vezes, desenvolvedores de sites ativam a opção “Evitar que mecanismos de busca indexem este site” nas Configurações de Leitura do WordPress durante a fase de criação (Staging), para que o site incompleto não apareça no Google. O problema? Eles esquecem de desmarcar essa opção ao lançar o site.
Resultado: O site vai ao ar, mas para o Google, ele não existe.
Recomendação do especialista: Sempre verifique o arquivo robots.txt manualmente no dia do lançamento. Se vir Disallow: /, apague imediatamente.
Há 10 anos, era comum bloquear as pastas /wp-content/ e /wp-includes/ para “economizar” a visita do robô. Hoje, fazer isso é suicídio de SEO.
O Google agora usa Mobile-First Indexing. Isso significa que o robô não apenas lê o texto; ele renderiza a página como se fosse um celular de última geração. Ele precisa carregar o CSS (design) e o JavaScript (interatividade) para saber se o seu site é responsivo, se os botões são clicáveis e se o layout não quebra.
Se você bloquear o acesso a esses arquivos no robots.txt, o Google “verá” seu site como uma página quebrada e sem estilo, derrubando seus rankings.
O que NÃO bloquear:
- Pastas de CSS e JS.
- Pastas de Imagens (uploads).
- Pastas de Fontes e Ícones.
Protegendo o Admin (wp-admin) sem quebrar o site
Você não quer o Google vasculhando sua área de login, certo? Bloquear o /wp-admin/ é uma boa prática de segurança e economia de recursos. Porém, existe uma pegadinha.
O WordPress usa um arquivo chamado admin-ajax.php (que fica dentro da pasta admin) para executar funções dinâmicas no front-end do site, como formulários de contato, carregamento infinito e filtros de produtos.
Se você bloquear a pasta inteira sem exceção, essas funções podem parar de funcionar para o bot, e o Google achará que seu site está com defeito.
A sintaxe correta é sempre:
Isso diz: “Não entre na administração, exceto neste arquivo específico que o site precisa para funcionar.”
Auditoria e Validação Técnica do robots.txt
No mundo da Engenharia de Busca, a regra número um é: “Confie, mas verifique”.
Configurar o robots.txt é apenas metade do trabalho. A outra metade é garantir que o Googlebot está lendo (ou ignorando) exatamente o que você planejou. Um erro silencioso aqui pode levar semanas para ser percebido, custando tráfego valioso.
Para evitar surpresas, utilizamos ferramentas oficiais de diagnóstico.
O Teste Definitivo no Google Search Console
A ferramenta mais poderosa para isso é gratuita e vem direto da fonte: o Google Search Console (GSC).
Se você ainda não cadastrou seu site lá, pare tudo e faça isso agora. Dentro do GSC, existe uma funcionalidade (muitas vezes escondida no menu “Configurações” ou na ferramenta legada “Testador de robots.txt”) que simula a visita do robô.
Como validar em 3 passos:
- Ferramenta de Inspeção de URL: Cole o endereço de uma página que você quer que apareça no Google (ex: sua Home ou um Artigo de Blog).
- Clique em “Testar URL Publicado”: O GSC vai tentar acessar a página em tempo real.
- Resultado: Se aparecer “URL está disponível para o Google”, seu robots.txt está correto (permitindo o acesso). Se aparecer “Bloqueada pelo robots.txt”, você tem um problema grave para resolver (a menos que a intenção fosse realmente bloquear).
Dica de Especialista: Faça o teste inverso também. Pegue uma URL que você bloqueou (como /wp-admin/) e teste. O resultado deve ser “Bloqueada”. Isso confirma que sua proteção está ativa.
Monitorando o Relatório de Indexação (Páginas)
O GSC possui um relatório chamado Indexação de Páginas (antigo “Cobertura”). Ele é o raio-X da saúde do seu site.
Procure pela aba “Bloqueada pelo robots.txt”.
- Cenário Bom: Ver URLs administrativas, feeds, tags de busca interna e páginas de login listadas aqui. Significa que o arquivo está funcionando e economizando seu Crawl Budget.
- Cenário Ruim: Ver seus artigos importantes, produtos ou páginas de serviço listadas aqui. Isso é um alerta vermelho de configuração errada.
Na ARD Marketing a rotina de manutenção de sites, verificamos esse relatório semanalmente para garantir que nenhuma atualização de plugin ou mudança de servidor alterou as regras de acesso inadvertidamente.
Conclusão: O Controle Técnico como Pilar da Autoridade
Dominar o robots.txt não é apenas sobre “agradar robôs”. É sobre soberania digital.
Ao configurar corretamente o arquivo robots.txt, você decide quem entra na sua “casa digital”. Você protege seu conteúdo contra o treinamento não autorizado de IAs, economiza recursos do servidor, acelera a indexação das páginas que realmente vendem e evita que áreas administrativas diluam sua autoridade.
Se tudo isso parece técnico demais ou arriscado para fazer sozinho, lembre-se que a base de um site de alta performance começa na arquitetura.
Na ARD Marketing, não apenas desenvolvemos sites bonitos; nós entregamos uma infraestrutura de SEO Técnico pronta para competir. Do bloqueio de bots indesejados à otimização do Crawl Budget, cuidamos dos bastidores para que você foque apenas no crescimento do seu negócio.
Quer um site blindado e otimizado para o futuro da busca? Conheça nosso serviço de Desenvolvimento de Sites (clique aqui) e comece do jeito certo.